Trong bài này
“Cà phê này cần thêm một chút đường” và “Chiếc xe đang chạy trên đường” cùng có chữ “đường”, nhưng nói về hai điều khác nhau. Khi nhận một câu hỏi chứa từ đó, AI dựa vào đâu để chọn cách diễn giải? Và vì sao hỏi lại cùng một câu, chúng ta đôi khi nhận được cách trả lời khác?
Bài này giải thích mô hình ngôn ngữ lớn, thường gọi là LLM, với trọng tâm là những mô hình tạo văn bản bằng cách sinh token nối tiếp. Đây là một cách vận hành phổ biến trong chatbot hiện đại, không phải cơ chế chung của mọi AI. Có mô hình ngôn ngữ chủ yếu tạo biểu diễn để phân loại, và có mô hình dùng cấu trúc khác để thực hiện nhiệm vụ.
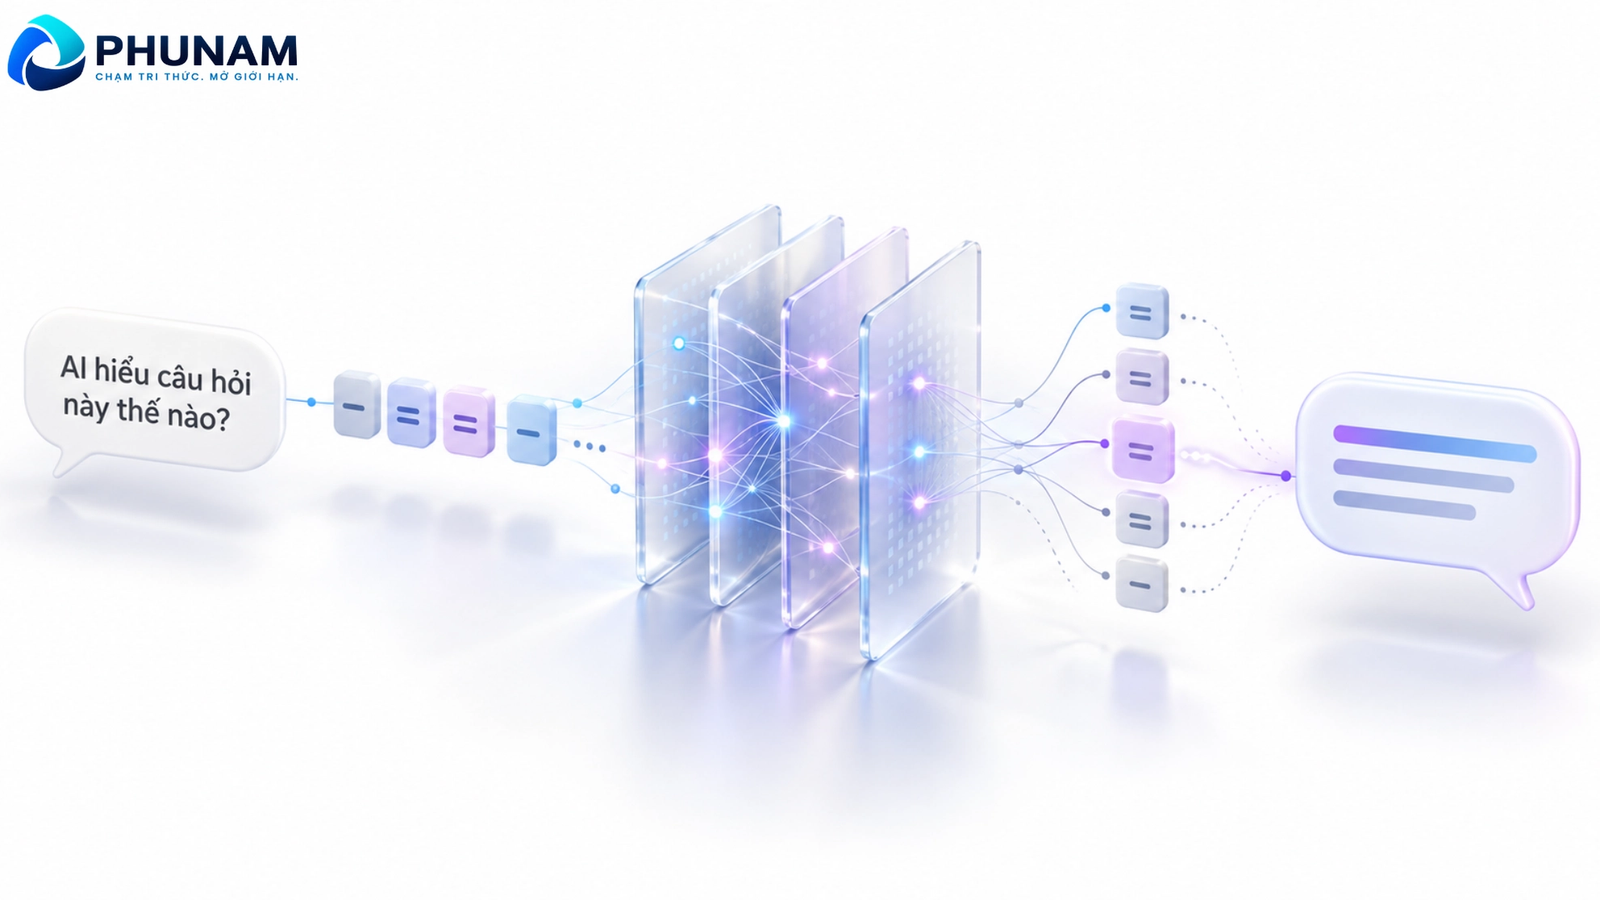
Các tham số đã học định hình cách mô hình xử lý. Khi trả lời, nó kết hợp năng lực đó với thông tin đang được cung cấp. Câu hỏi trung tâm ở đây là: văn bản đầu vào đi qua những biến đổi nào để trở thành câu trả lời?
1. Văn bản đi vào mô hình dưới dạng nào?
Mô hình không xử lý chữ bằng cách nhìn trang văn bản giống người đọc. Trước tiên, một bộ tách token, hay tokenizer, chuyển văn bản thành các đơn vị mà mô hình sử dụng, gọi là token.
Token có thể tương ứng với một từ, một phần của từ, dấu câu hoặc một phần biểu diễn của ký tự. Ranh giới token phụ thuộc bộ tách và tập đơn vị mà nó hỗ trợ. Vì vậy, không thể mặc định một từ là một token, cũng không thể đếm khoảng trắng để biết chính xác số token.
Điều này đặc biệt cần chú ý với tiếng Việt: khoảng trắng thường ngăn cách các tiếng, trong khi một từ có thể gồm nhiều tiếng. Cách viết có dấu, dấu câu và quy tắc của từng bộ tách cũng ảnh hưởng kết quả. Một tỷ lệ quy đổi từ sang token dùng cho tiếng Anh không tự áp dụng chính xác cho văn bản tiếng Việt.
Mỗi token được gắn với một mã số nhận diện trong bộ tách tương ứng. Mã số cho biết đang dùng đơn vị nào, không phải điểm đo ý nghĩa hay mức quan trọng. Token có mã số lớn hơn không vì thế mà “giàu ý nghĩa” hơn.
Chia văn bản thành những phần nhỏ có thể giúp biểu diễn từ ít gặp bằng các đơn vị đã biết. Nhưng biểu diễn được một từ chưa có nghĩa mô hình đã hiểu đúng nó trong mọi tình huống. Tách token giải quyết cách đưa văn bản vào hệ tính toán; diễn giải nội dung cần những bước xử lý tiếp theo.
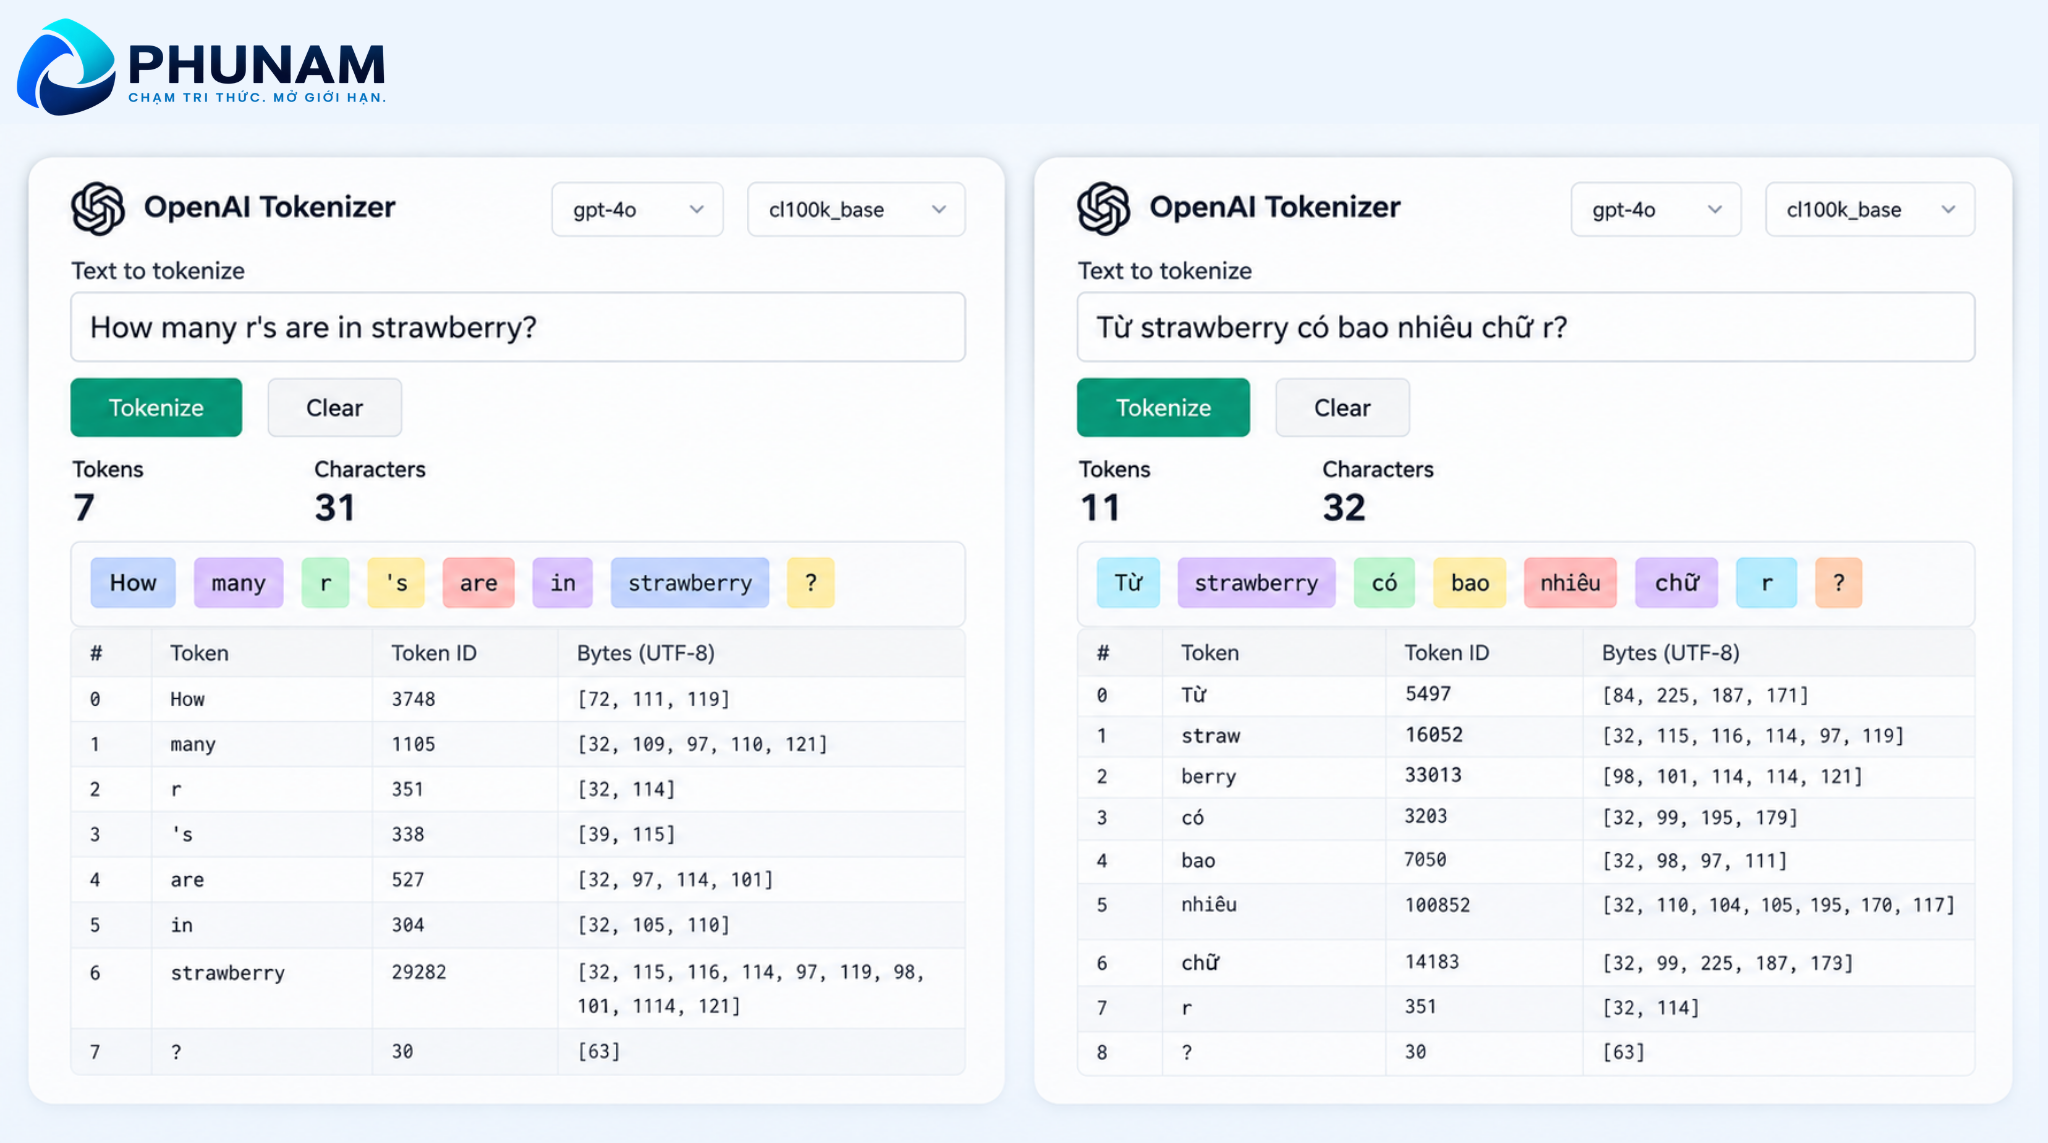
Một ví dụ nổi tiếng là câu hỏi: “Từ strawberry có bao nhiêu chữ r?”. Đáp án là 3, nhưng một số mô hình ngôn ngữ từng trả lời sai ở những nhiệm vụ đếm ký tự như vậy. Một nghiên cứu năm 2024 về lỗi đếm chữ của LLM cho thấy không nên quy toàn bộ hiện tượng này chỉ cho tokenizer: các mô hình có thể nhận diện chữ cái nhưng vẫn gặp khó khi đếm, và lỗi còn liên quan đến độ phức tạp của thao tác đếm cũng như số ký tự hoặc token trong từ. Ví dụ này cho thấy xử lý văn bản theo token có thể khiến những nhiệm vụ ở cấp ký tự không trực tiếp như cách người dùng nhìn từng chữ.
Bạn có thể thử nhập “strawberry” hoặc một câu tiếng Việt vào Tokenizer của OpenAI để xem văn bản được chia thành token như thế nào. Kết quả token hóa giúp quan sát các đơn vị đầu vào mà mô hình xử lý, nhưng không phải phép đo trực tiếp khả năng hiểu hay đếm ký tự của mô hình.
Trong một cuộc trò chuyện, đầu vào có thể gồm câu hỏi hiện tại, chỉ dẫn cho trợ lý và các phần hội thoại được ứng dụng gửi kèm. Thông tin về vai trò và ranh giới lượt nói giúp mô hình nhận biết cấu trúc trao đổi. Phần thông tin được cung cấp cho lượt xử lý gọi là ngữ cảnh. Vì vậy, câu hỏi đang hiển thị cho người dùng có thể chỉ là một phần của đầu vào thực tế.
2. Mô hình xử lý ý nghĩa và quan hệ theo ngữ cảnh thế nào?
Từ mã token đến biểu diễn số
Mã token trước hết được liên hệ với một embedding, tức một dãy giá trị số đã được học để làm đầu vào cho tính toán. Có thể hình dung đây là cách mô hình biểu diễn đơn vị văn bản trong không gian số. Mã nhận diện và embedding có vai trò khác nhau: một bên xác định đơn vị, một bên cung cấp biểu diễn dùng trong xử lý.
Embedding không phải một dòng từ điển giải thích đầy đủ nghĩa của từ. Qua các lớp tính toán, mô hình tạo những biểu diễn theo ngữ cảnh, kết hợp thông tin về nội dung, vị trí và quan hệ giữa các phần của văn bản.
Trong hai câu mở đầu, các thông tin như “cà phê”, “thêm một chút” hoặc “xe”, “chạy trên” giúp phân biệt đường ăn với đường đi. Cách biểu diễn và xử lý để tạo câu trả lời vì vậy không chỉ phụ thuộc riêng chữ “đường”. Nếu yêu cầu chỉ là “Hãy giải thích đường”, ngữ cảnh chưa xác định một nghĩa duy nhất; khả năng tạo câu trả lời không tự cho biết người hỏi đang nghĩ đến nghĩa nào.
Vị trí và thứ tự cũng có ý nghĩa. “Lan nhờ Minh giúp” khác “Minh nhờ Lan giúp”, dù dùng cùng những từ ấy. Mô hình cần thông tin về thứ tự để phân biệt ai nhờ ai, thay vì chỉ nhìn một tập hợp từ xuất hiện.
Attention kết nối những phần liên quan
Attention là cơ chế tính toán mức liên hệ giữa các biểu diễn, rồi kết hợp thông tin theo những trọng số khác nhau. Nhờ đó, một phần văn bản có thể được xử lý dựa vào những phần có liên quan trong ngữ cảnh, kể cả khi chúng không nằm sát nhau.
Chẳng hạn, trong một câu dài, thông tin ở đầu câu có thể giúp xác định một đại từ xuất hiện về sau đang nói đến ai. Attention hỗ trợ đưa quan hệ ấy vào tính toán. Nó không cần quy về thao tác dò từ đứng gần nhất, cũng không mặc định phần xa hơn là phần ít quan trọng hơn.
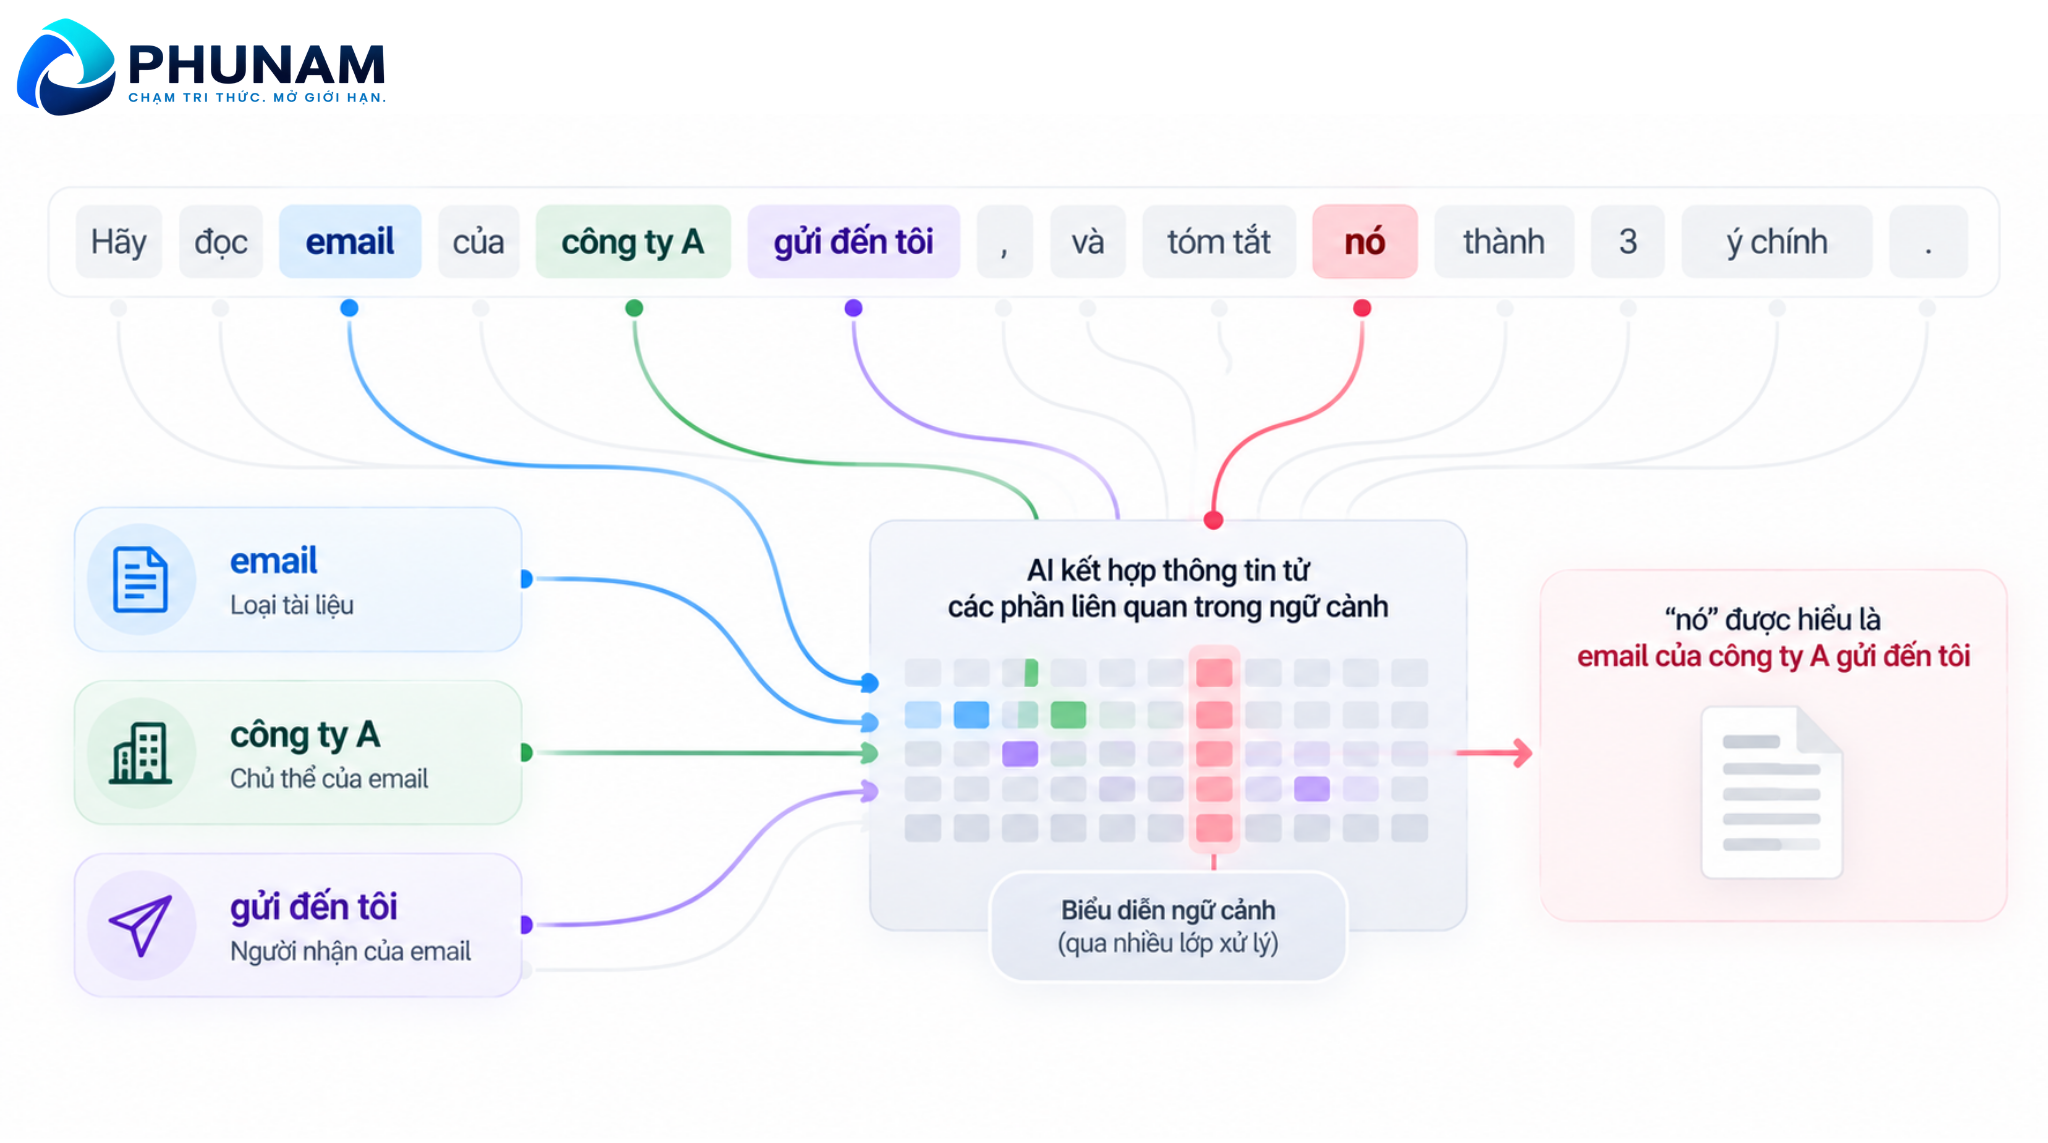
Self-attention là attention giữa các vị trí thuộc cùng một chuỗi. Nhiều đầu attention cho phép tính những kiểu liên hệ khác nhau song song. Không nên hiểu mỗi đầu luôn được giao sẵn một nhiệm vụ cố định như “chỉ tìm chủ ngữ” hoặc “chỉ tìm ý chính”; các quan hệ được học có thể phức tạp hơn.
Transformer là một cách tổ chức mạng nơron, kết hợp attention với các phép biến đổi khác qua nhiều lớp. Attention là thành phần quan trọng, nhưng không phải toàn bộ cơ chế xử lý. Mỗi lớp tiếp tục biến đổi biểu diễn từ lớp trước để phục vụ việc tính đầu ra.
Từ “attention” thường được dịch là “chú ý”, nhưng ở đây nó chỉ một cơ chế tính toán. Trọng số attention không phải mức quan tâm có ý thức, và chỉ nhìn các trọng số ấy chưa giải thích đầy đủ mọi hoạt động bên trong mô hình.
Với cách sinh nối tiếp đang được giải thích, phép tính tại một vị trí sử dụng thông tin được phép lấy từ các vị trí trước và chính vị trí đó. Khi tạo phần tiếp theo của câu trả lời, mô hình có thể dùng câu hỏi đã được cung cấp cùng phần trả lời đã sinh. Nó không nhìn thấy các token tương lai chưa được tạo. Dự đoán một nội dung có thể xuất hiện về sau khác với đọc sẵn nội dung ấy.
3. Từ tính toán bên trong đến câu trả lời
Sau khi xử lý ngữ cảnh, mô hình tạo các giá trị dùng để xác định phân bố xác suất cho token tiếp theo. Phân bố này mô tả mức ưu tiên tương đối giữa những ứng viên theo mô hình và điều kiện xử lý hiện tại.
Quy trình sinh thường tiếp tục như sau: chọn một token theo cách chọn đầu ra đang sử dụng, thêm token đó vào chuỗi, rồi tính tiếp dựa trên chuỗi đã có. Khi chuỗi thay đổi, điều kiện cho lần dự đoán tiếp theo cũng thay đổi.
| Khâu trong luồng xử lý giản lược | Kết quả tạo ra | Ý nghĩa |
|---|---|---|
| Tách và mã hóa văn bản | Chuỗi mã token | Đưa văn bản về các đơn vị mô hình sử dụng |
| Tạo và biến đổi biểu diễn | Biểu diễn số có thông tin về vị trí và ngữ cảnh | Cung cấp cơ sở tính toán quan hệ và nội dung |
| Tính các ứng viên tiếp theo | Phân bố xác suất token | Ước lượng những lựa chọn có thể nối tiếp chuỗi |
| Chọn và thêm token | Chuỗi được kéo dài | Tạo điều kiện mới cho bước sinh sau |
| Giải mã đầu ra | Văn bản người dùng đọc được | Chuyển chuỗi mã token về dạng văn bản |
Bảng mô tả cơ chế ở mức khái quát, không có nghĩa mỗi hàng là một hệ thống độc lập hoặc toàn bộ câu trả lời đã được viết sẵn trước khi xuất hiện.
Việc sinh có thể kết thúc khi gặp dấu hiệu kết thúc được mô hình sử dụng hoặc khi chạm giới hạn do hệ thống đặt. Vì vậy, một câu trả lời bị ngắt chưa tự chứng minh mô hình đã hết khả năng diễn đạt ý tiếp theo.
Xác suất token không phải xác suất toàn bộ câu trả lời đúng. Nó mô tả một lựa chọn trong quá trình sinh. Một chuỗi nghe tự nhiên vẫn có thể chứa thông tin sai; sự phù hợp về cách diễn đạt và sự đúng đắn của nội dung cần được đánh giá riêng.
4. Vì sao cùng câu hỏi có thể nhận những câu trả lời khác nhau?
Một nguyên nhân nằm ở cách chọn token. Có cách ưu tiên ứng viên có xác suất cao nhất tại mỗi bước. Cũng có cách lấy mẫu theo xác suất, cho phép chọn giữa nhiều ứng viên thay vì chỉ lấy ứng viên đứng đầu.
Minh họa giả định: một mô hình giản lược có ba ứng viên ở một bước sinh, với phân bố như dưới đây. Các con số được tự dựng để giải thích cơ chế, không phải kết quả đo từ một mô hình thực.
| Ứng viên token | Xác suất giả định |
|---|---|
| Ứng viên thứ nhất | 50% |
| Ứng viên thứ hai | 30% |
| Ứng viên thứ ba | 20% |
Nếu chọn xác suất cao nhất, quy trình chọn ứng viên thứ nhất ở bước này. Nếu lấy mẫu theo đúng phân bố trên, ứng viên thứ hai hoặc thứ ba cũng có cơ hội được chọn. Lấy mẫu không có nghĩa ba ứng viên được chọn với cơ hội ngang nhau.
Sau một lựa chọn khác nhau, chuỗi đầu ra đã khác. Các bước sinh tiếp theo dựa vào chuỗi ấy, nên khác biệt có thể lan sang cấu trúc, cách diễn đạt hoặc nội dung về sau. Cách chọn token vì vậy ảnh hưởng cả quá trình tạo câu trả lời, không chỉ thay vài chữ sau khi văn bản đã hoàn thành.
Ưu tiên xác suất cao nhất tại từng bước cũng không bảo đảm toàn bộ chuỗi là lựa chọn tốt nhất. Quyết định tốt nhất cho bước hiện tại và kết quả tốt nhất của cả câu trả lời là hai điều cần phân biệt.
Nhiệt độ, hay temperature, là thiết lập điều chỉnh cách phân bổ xác suất khi chọn token. Trong cách lấy mẫu thông thường, nhiệt độ cao hơn làm phân bố bớt tập trung vào ứng viên đứng đầu, có thể tạo nhiều biến thể hơn. Đây là thay đổi cách lựa chọn đầu ra, không phải thang đo độ thông minh hay độ chính xác.
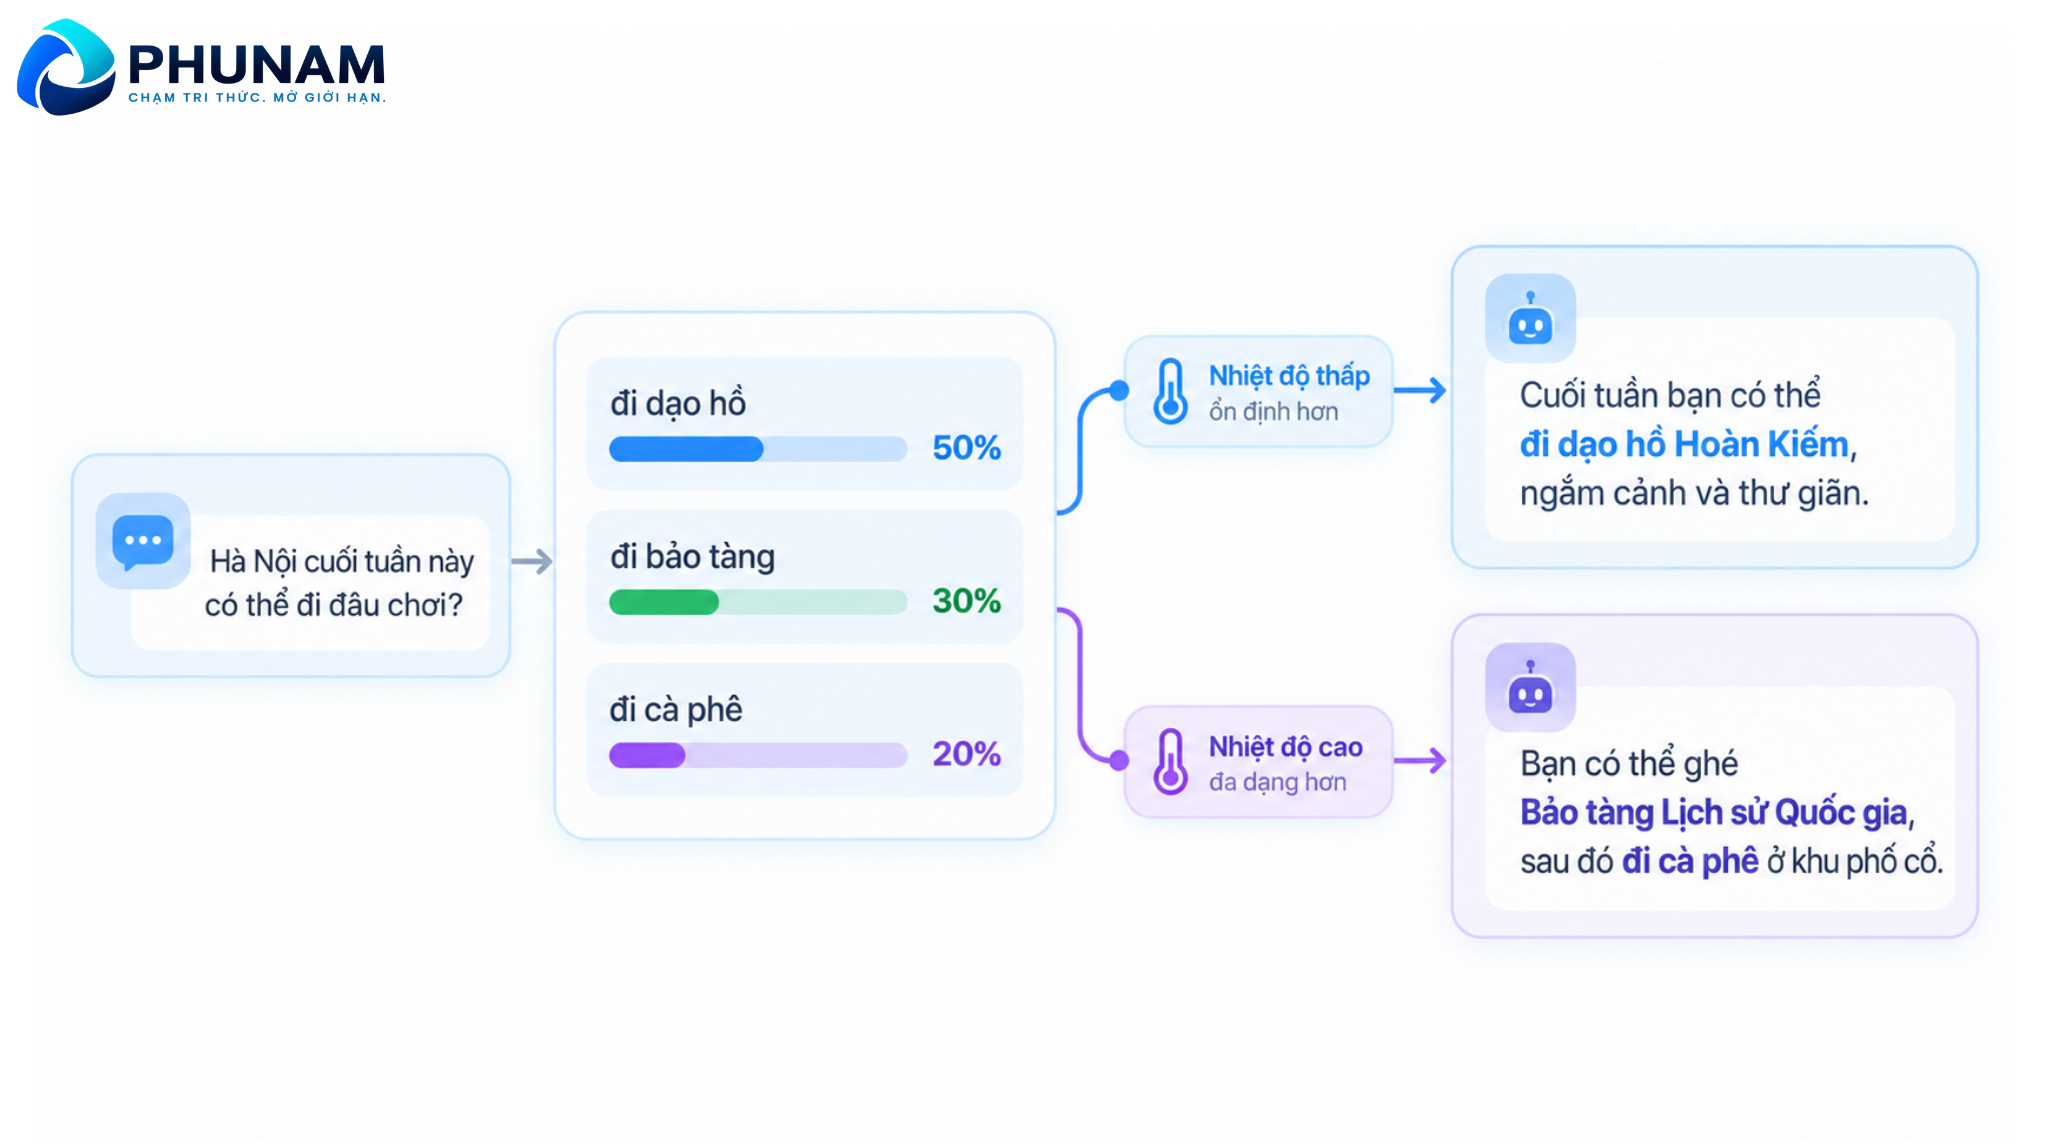
Đầu vào cũng có thể là nguyên nhân: cùng câu hỏi hiển thị, nhưng các thông tin được gửi kèm khác nhau sẽ tạo ngữ cảnh khác nhau. Chỉ quan sát hai câu trả lời khác nhau chưa đủ biết thay đổi đến từ ngữ cảnh, cách chọn token hay một điều kiện vận hành khác.
5. Sinh từng token nói lên điều gì về khả năng hiểu ngôn ngữ?
Một bước sinh chỉ bổ sung token tiếp theo, nhưng phép tính để chọn token ấy có thể sử dụng những biểu diễn và quan hệ phức tạp. Không thể chỉ nhìn đơn vị đầu ra nhỏ rồi suy ra mô hình chỉ xét một từ riêng lẻ hoặc chỉ ghép những câu có sẵn.
Trong nghiên cứu On the Biology of a Large Language Model do Anthropic công bố năm 2025, nhóm nghiên cứu phân tích Claude 3.5 Haiku trong nhiệm vụ hoàn thành thơ có vần bằng tiếng Anh cho thấy điều này trong nhiệm vụ hoàn thành thơ có vần bằng tiếng Anh. Trước khi dòng tiếp theo bắt đầu, đã có hoạt động của những biểu diễn liên quan đến các từ có thể dùng ở cuối dòng. Khi can thiệp vào các biểu diễn đó, cách viết và từ kết thúc có thể thay đổi theo. Kết quả là bằng chứng cho cơ chế định hướng nội dung phía sau trong các trường hợp được nghiên cứu, dù đầu ra vẫn được sinh nối tiếp.
Phân tích này dùng một mô hình thay thế dễ diễn giải hơn để đề xuất cơ chế, rồi kiểm tra bằng can thiệp trong mô hình gốc. Phương pháp chỉ nắm được một phần hoạt động bên trong, và các ca được trình bày là những trường hợp đã phân tích thành công. Nó không chứng minh mọi câu trả lời đều được lập kế hoạch đầy đủ từ đầu, cũng không phải bản ghi toàn bộ “suy nghĩ” của mô hình.
Dự kiến nội dung chưa viết không đồng nghĩa nhìn thấy token tương lai. Mô hình có thể hình thành biểu diễn về một đích có thể đạt tới dựa trên thông tin hiện có, rồi tạo các phần dẫn đến đích ấy. Điều này khác với việc đã có toàn bộ chuỗi tương lai để đọc hoặc bảo đảm rằng đích ban đầu sẽ được giữ nguyên.
Khả năng xử lý ngôn ngữ có thể được kiểm tra qua việc phân biệt vai trò trong câu, giải nghĩa theo ngữ cảnh, tóm tắt hoặc đáp ứng yêu cầu trên văn bản mới. Kết quả nhiệm vụ cho biết năng lực quan sát được; trải nghiệm chủ quan hay cách hiểu giống con người là những kết luận cần bằng chứng khác.
Luồng xử lý token giải thích cách văn bản được tạo ra. Để đánh giá nội dung, cần xem dữ kiện và quan hệ được diễn giải: câu trả lời trôi chảy vẫn có thể chứa khẳng định thiếu căn cứ.